NoSQL hype skončil. Default je Postgres
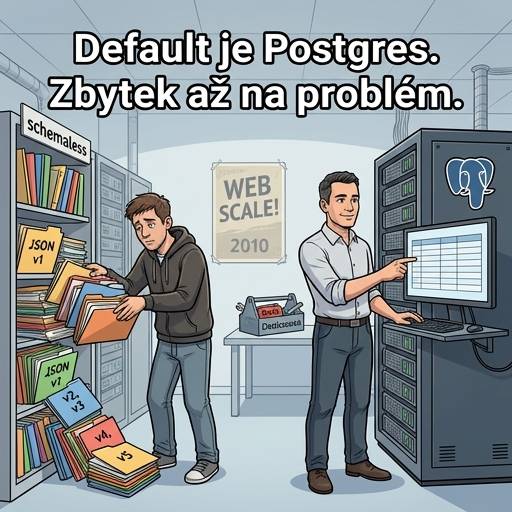
Kolem roku 2010 se půlka IT světa rozhodla, že relační databáze jsou mrtvé. Google, Amazon a Facebook publikovali, jak škálují na stovky milionů uživatelů, a najednou všichni chtěli “web scale”. Vznikly MongoDB, Cassandra, CouchDB a JSON dokumenty bez schématu vypadaly jako budoucnost.
O pár let později Google sám přešel z Bigtable na Spanner. Distribuované SQL se silnou konzistencí.
Většina firem totiž “web scale” nikdy nepotřebovala. Hardware mezitím zrychlil a zlevnil - NVMe disky, stovky GB RAM, desítky jader. Jeden pořádný Postgres s replikou dnes utáhne drtivou většinu aplikací, které firmy reálně provozují.
“Schemaless” v praxi znamená, že schéma máte rozházené v kódu aplikace a nikdo ho nevynucuje. Po pár letech je v jedné kolekci pět verzí stejného dokumentu. A data jsou stejně relační - zákazník, objednávka, faktura. Dřív nebo později potřebujete JOIN nebo transakci a programátor to pak lepí v aplikaci, pomalu a s chybami. Kyle Kingsbury navíc svými Jepsen testy ukázal, že řada distribuovaných databází při výpadku sítě ztrácí data, i když marketing sliboval opak.
Mezitím se obě strany potkaly. Postgres od verze 9.4 ukládá a indexuje JSON, MongoDB má od verze 4.0 transakce. Hlavní argument “potřebuju ukládat dokumenty” tím z velké části odpadl.
NoSQL má svoje místo: Redis na cache a fronty, Elasticsearch na fulltext a logy, Cassandra tam, kde zapisujete obří objemy dat. Teď se celý příběh opakuje s vektorovými databázemi pro AI - a pgvector v Postgresu většině firem zase stačí.
Výchozí volba je proto Postgres. Specializovanou databázi přidejte, až máte konkrétní problém, který Postgres prokazatelně neřeší. Ne proto, že je zrovna v módě.
Jak vybírat technologie podle reálné potřeby a neplatit za módní vlny, rozepisuju v newsletteru “Sám sobě ajťákem”. Chodí zhruba jednou měsíčně, žádné výplňové e-maily. martinkonicek.eu/newsletter/